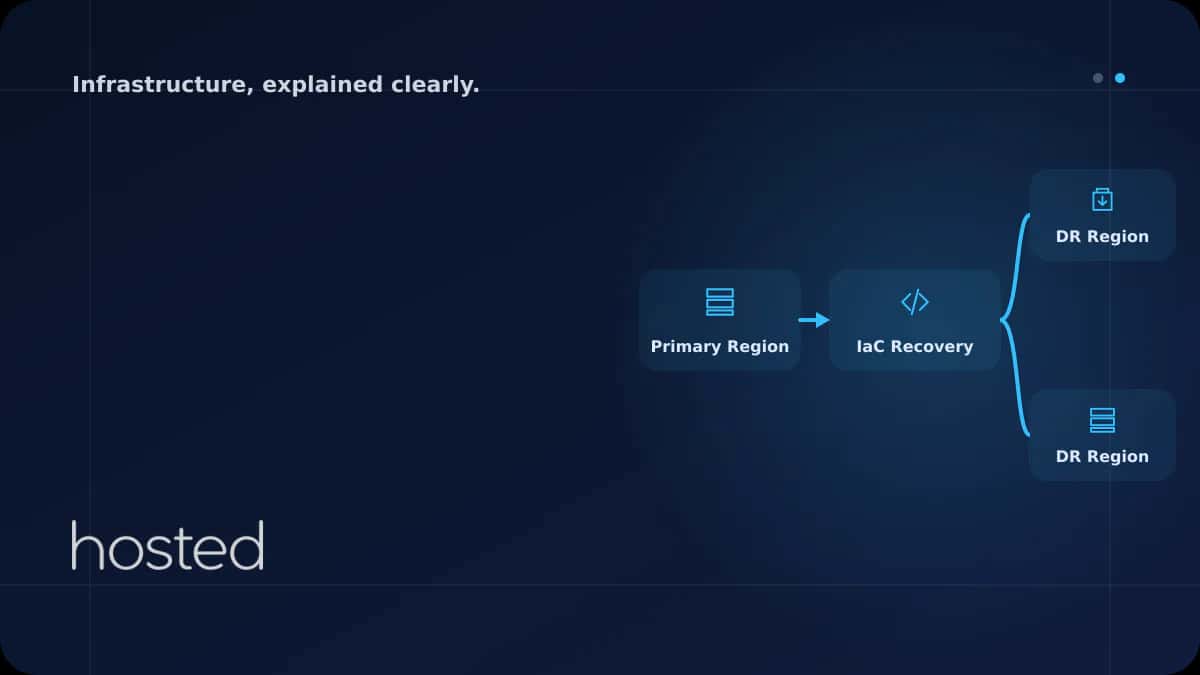
Izrada plana oporavka od katastrofe pomoću Infrastructure as Code
Otkazi servera, ispadi data centra ili sajber napadi mogu se desiti u bilo kom trenutku. Plan oporavka od katastrofe definišite kao kod i infrastrukturu ponovo kreirajte za nekoliko minuta.
Ahmet Yılmaz
Viši inženjer infrastrukture
Otkazi servera, ispadi data centra ili sajber napadi mogu se desiti u bilo kom trenutku. Ako plan oporavka od katastrofe definišete kao kod pomoću Infrastructure as Code (IaC), infrastrukturu možete ponovo kreirati za nekoliko minuta. Ovaj vodič obuhvata sve, od koncepata RPO/RTO do Terraform multi-region konfiguracije, od automatizovanih bekapa do automatizacije failovera.
Osnovni DR koncepti: RPO i RTO
Dve ključne metrike čine temelj plana oporavka od katastrofe: RPO (Recovery Point Objective) određuje prihvatljivo trajanje gubitka podataka, dok RTO (Recovery Time Objective) određuje prihvatljivo trajanje zastoja.
| Metrika | Definicija | Primer | IaC cilj |
|---|---|---|---|
| RPO | Maksimalno trajanje gubitka podataka | Poslednjih 1 sat podataka | Minuti (automatska replikacija) |
| RTO | Maksimalno trajanje zastoja | 4 sata | Minuti (automatski failover) |
| MTTR | Prosečno vreme popravke | 2 sata | Minuti (ponovno kreiranje iz koda) |
💡 Savet: Vrednosti RPO i RTO odredite prema poslovnim zahtevima. Za sajtove elektronske trgovine ciljajte RPO od 5 minuta i RTO od 15 minuta, dok interni alati mogu prihvatiti RPO od 1 sata i RTO od 4 sata.
Multi-region infrastruktura pomoću Terraforma
Pomoću Terraform modula istu infrastrukturu možete definisati kao kod i u primarnom i u DR regionu. Tako DR region možete aktivirati za nekoliko minuta u slučaju katastrofe.
# Primary region
module "primary" {
  source    = "./modules/infrastructure"
  region    = "eu-west-1"
  env       = "production"
  is_primary = true

  instance_count = 3
  instance_type  = "c5.xlarge"
  db_multi_az    = true
}

# DR region (Standby)
module "dr" {
  source    = "./modules/infrastructure"
  region    = "us-east-1"
  env       = "dr"
  is_primary = false

  # Fewer resources in DR (cost optimization)
  instance_count = 1
  instance_type  = "c5.large"
  db_multi_az    = false
}
Konfiguracija automatizovanog bekapa pomoću IaC-a
Definisanjem strategije bekapa kao koda možete kreirati dosledne i ponovljive procese bekapa. Sledeća Terraform konfiguracija automatizuje bekap baze podataka i fajl sistema.
# Automated database backup
resource "aws_db_instance" "primary" {
  identifier              = "app-db-primary"
  engine                  = "postgres"
  engine_version          = "15.4"
  instance_class          = "db.r6g.large"

  # Backup settings
  backup_retention_period = 30
  backup_window           = "03:00-04:00"
  copy_tags_to_snapshot   = true

  # Cross-region replication
  replicate_source_db     = null
}

# Cross-region replica for DR
resource "aws_db_instance" "dr_replica" {
  provider            = aws.dr
  replicate_source_db = aws_db_instance.primary.arn
  instance_class      = "db.r6g.large"
}
Automatizacija failovera
Ručni procesi failovera povećavaju rizik od grešaka i troše vreme. Automatski failover možete podesiti pomoću rutiranja zasnovanog na DNS-u.
# Health check - primary region
resource "aws_route53_health_check" "primary" {
  fqdn              = "primary.example.com"
  port              = 443
  type              = "HTTPS"
  resource_path     = "/health"
  failure_threshold = 3
  request_interval  = 10
}

# DNS failover record
resource "aws_route53_record" "primary" {
  zone_id         = var.zone_id
  name            = "app.example.com"
  type            = "A"
  set_identifier  = "primary"
  health_check_id = aws_route53_health_check.primary.id

  failover_routing_policy {
    type = "PRIMARY"
  }

  alias {
    name    = module.primary.lb_dns_name
    zone_id = module.primary.lb_zone_id
  }
}
⚠️ Upozorenje: Držite TTL za DNS failover niskim (oko 60 sekundi). Visoke TTL vrednosti mogu dovesti do toga da korisnici i nakon failovera budu usmeravani na staru IP adresu.
Kontrolna lista za testiranje DR-a
Bez redovnog testiranja DR plana ne možete biti sigurni da će raditi tokom stvarne katastrofe. Primenjujte sledeću kontrolnu listu svakog kvartala.
- ✅ Proverite da je Terraform state datoteka ažurna u udaljenom backendu
-
✅
Pokrenite
terraform planu DR regionu da proverite odstupanja (drift) - ✅ Proverite kašnjenje sinhronizacije replike baze podataka (< 1 minut)
- ✅ Simulirajte DNS failover i izmerite vreme prelaska
- ✅ Pokrenite smoke testove aplikacije u DR okruženju
- ✅ Izvršite testove vraćanja iz bekapa
- ✅ Testirajte proceduru failbacka (povratak u primarni region)
- ✅ Dokumentujte sve rezultate i izvestite da li su ciljevi RPO/RTO ispunjeni
Za osnove Terraforma pogledajte naš vodič o Terraform IaC-u. Za strategije bekapa pogledajte naš vodič o snapshotovima i bekapu. Za nadzor servera pogledajte naš vodič o Prometheus + Grafana. HashiCorp Terraform tutorijali i AWS whitepaper o oporavku od katastrofe vredni su dodatni izvori.
Često postavljana pitanja
Može li se oporavak od katastrofe sprovesti bez IaC-a?
Može, ali ručni procesi povećavaju rizik od grešaka i produžavaju vreme oporavka. Uz IaC infrastrukturu možete ponovo kreirati za nekoliko minuta. Operacije koje bi ručnom konfiguracijom mogle trajati satima, pa čak i danima, postaju automatizovane.
Da li DR region mora stalno da radi?
Ne. Troškove možete smanjiti strategijama warm standby (rad sa minimalnim resursima) ili pilot light (samo replikacija baze podataka). U slučaju katastrofe resurse možete brzo skalirati pomoću IaC-a.
Šta se dešava ako se izgubi Terraform state datoteka?
Ako se state datoteka izgubi, Terraform ne može da prepozna postojeću infrastrukturu. State čuvajte u udaljenom backendu poput S3 + DynamoDB uz uključeno verzionisanje i zaključavanje. Bekap same state datoteke je od presudnog značaja.
Koliko često treba sprovoditi DR testove?
Potpune DR testove treba sprovoditi najmanje jednom kvartalno. Za kritične sisteme preporučuju se mesečni testovi. DR plan treba proveriti i nakon svake veće promene infrastrukture.
Zaključak
Uz Infrastructure as Code plan oporavka od katastrofe postaje verzionisan, testabilan i ponovljiv. Definišite infrastrukturu Terraform multi-region modulima, podesite automatizovane mehanizme bekapa i failovera i uverite se da plan funkcioniše redovnim DR testovima.
Pouzdana infrastruktura za oporavak od katastrofe
Sa poverenjem sprovedite svoj DR plan na Hosted Cloud serverima.
Pogledajte pakete cloud servera →Ahmet Yılmaz
Viši inženjer infrastrukture
Sa više od 10 godina iskustva u cloud infrastrukturi i DevOps-u, Ahmet se specijalizovao za Kubernetes, Terraform i arhitekture visoke dostupnosti.
Komentari uskoro