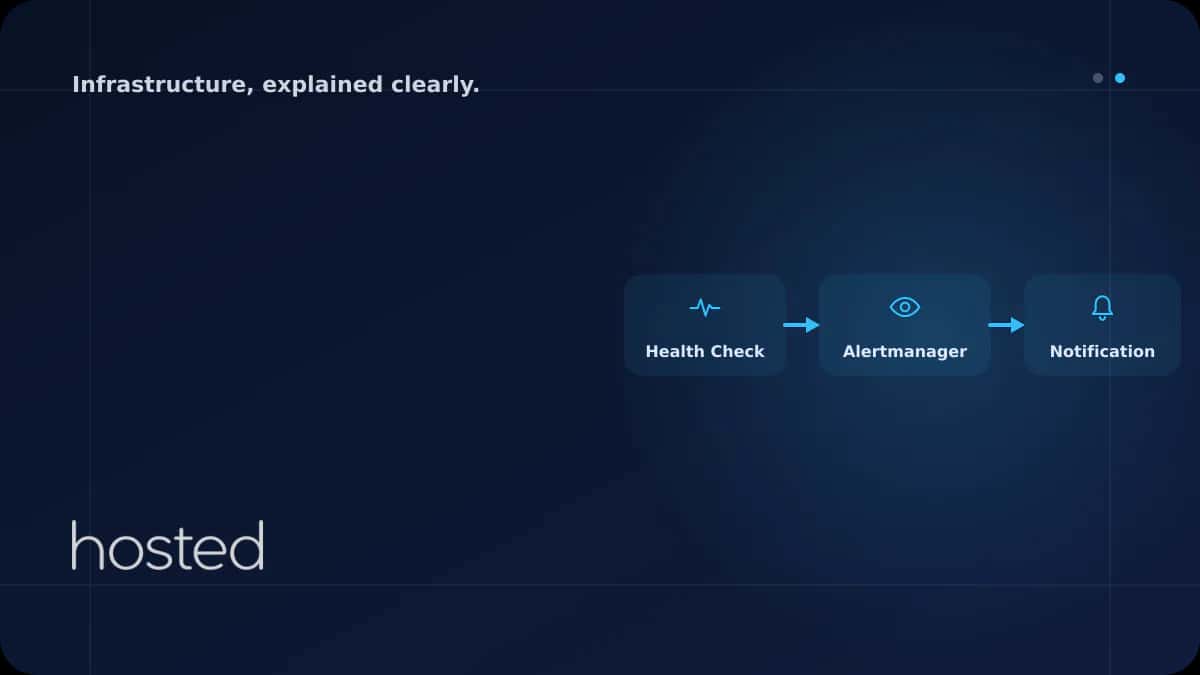
Nadzor dostupnosti: automatizacija obaveštenja o prekidu rada uz Alertmanager
Automatizovani nadzor dostupnosti izvršava HTTP, TCP i DNS provere i šalje obaveštenja preko Alertmanager-a kada dođe do prekida. Vodič obuhvata Blackbox Exporter, alert pravila i dežurstva.
Ahmet Yılmaz
Viši inženjer infrastrukture
Otkriti da je veb sajt ili API prestao da radi pre nego što to primete vaši klijenti — temelj je operativne pouzdanosti. Umesto ručnih provera, možete postaviti automatizovan nadzor dostupnosti koji neprekidno izvršava HTTP, TCP i DNS provere ispravnosti i šalje trenutna obaveštenja putem Slack-a, PagerDuty-ja ili emaila preko Alertmanager-a kada dođe do prekida. Ovaj vodič obuhvata sve, od postavljanja nadzora dostupnosti pomoću Prometheus Blackbox Exporter-a do konfiguracije Alertmanager-a, pravila upozorenja i upravljanja dežurstvima.
Zašto je nadzor dostupnosti ključan?
Prekid rada direktno znači gubitak prihoda. Za e-commerce sajt to može značiti hiljade dolara izgubljene prodaje u minuti; za SaaS aplikaciju to može značiti kršenje SLA-a i finansijske kazne. Proaktivnim nadzorom možete otkriti probleme i reagovati na njih pre nego što ih korisnici primete.
| Cilj dostupnosti | Dozvoljen godišnji prekid | Dozvoljen mesečni prekid |
|---|---|---|
| 99% (dve devetke) | 3 dana 15 sati | 7 sati 18 minuta |
| 99,9% (tri devetke) | 8 sati 46 minuta | 43 minuta 50 sekundi |
| 99,99% (četiri devetke) | 52 minuta 36 sekundi | 4 minuta 23 sekunde |
| 99,999% (pet devetki) | 5 minuta 16 sekundi | 26 sekundi |
💡 Realan cilj: Za većinu veb aplikacija 99,9% (tri devetke) razuman je cilj. To dozvoljava otprilike 43 minuta prekida mesečno. Ciljevi od 99,99% i više zahtevaju redundantnu infrastrukturu, automatski failover i tim koji je dežuran 24/7.
Nadzor endpointa pomoću Blackbox Exporter-a
Prometheus Blackbox Exporter proverava dostupnost endpointa preko HTTP, HTTPS, TCP, ICMP i DNS protokola. Simulira stvarno korisničko iskustvo tako što vašu aplikaciju posmatra spolja (black-box).
version: "3.8"
services:
  prometheus:
    image: prom/prometheus:v2.50.0
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml
      - ./alert-rules.yml:/etc/prometheus/alert-rules.yml
    ports:
      - "9090:9090"
    networks:
      - monitoring

  blackbox-exporter:
    image: prom/blackbox-exporter:v0.25.0
    volumes:
      - ./blackbox.yml:/etc/blackbox_exporter/config.yml
    ports:
      - "9115:9115"
    networks:
      - monitoring

  alertmanager:
    image: prom/alertmanager:v0.27.0
    volumes:
      - ./alertmanager.yml:/etc/alertmanager/alertmanager.yml
    ports:
      - "9093:9093"
    networks:
      - monitoring

networks:
  monitoring:
    driver: bridge
Konfiguracija Blackbox Exporter-a
Pomoću modula definišite koje provere Blackbox Exporter izvršava:
modules:
  http_2xx:
    prober: http
    timeout: 10s
    http:
      valid_http_versions: ["HTTP/1.1", "HTTP/2.0"]
      valid_status_codes: [200, 201, 301, 302]
      follow_redirects: true
      preferred_ip_protocol: ip4
      tls_config:
        insecure_skip_verify: false

  tcp_connect:
    prober: tcp
    timeout: 5s

  dns_check:
    prober: dns
    timeout: 5s
    dns:
      query_name: hosted.cloud
      query_type: A
      transport_protocol: udp

  ssl_expiry:
    prober: http
    timeout: 10s
    http:
      valid_status_codes: [200, 301, 302]
      tls_config:
        insecure_skip_verify: false
Prometheus konfiguracija prikupljanja (scrape)
Definišite scrape konfiguraciju za Prometheus kako bi proveravao ciljne endpointe preko Blackbox Exporter-a:
scrape_configs:
  - job_name: "blackbox-http"
    metrics_path: /probe
    params:
      module: [http_2xx]
    static_configs:
      - targets:
          - https://hosted.cloud
          - https://api.hosted.cloud/health
          - https://admin.hosted.cloud
    relabel_configs:
      - source_labels: [__address__]
        target_label: __param_target
      - source_labels: [__param_target]
        target_label: instance
      - target_label: __address__
        replacement: blackbox-exporter:9115
Prometheus pravila upozorenja
Pravila upozorenja pokreću Alertmanager obaveštenja kada su ispunjeni određeni uslovi. Osnovna pravila za nadzor dostupnosti:
groups:
  - name: uptime-alerts
    rules:
      # Endpoint completely unreachable
      - alert: EndpointDown
        expr: probe_success == 0
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "Endpoint {{ $labels.instance }} down"
          description: "{{ $labels.instance }} has been unreachable for 2 minutes."

      # Slow response time (over 2 seconds)
      - alert: HighResponseTime
        expr: probe_http_duration_seconds{phase="transfer"} > 2
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Slow response: {{ $labels.instance }}"
          description: "{{ $labels.instance }} response time has been over 2s for 5 minutes."

      # SSL certificate expiring within 14 days
      - alert: SSLCertExpiringSoon
        expr: (probe_ssl_earliest_cert_expiry - time()) / 86400 < 14
        for: 1h
        labels:
          severity: warning
        annotations:
          summary: "SSL cert expiring: {{ $labels.instance }}"
          description: "{{ $labels.instance }} SSL certificate expires in {{ $value | humanize }} days."

      # HTTP 5xx status code
      - alert: HTTPStatusError
        expr: probe_http_status_code >= 500
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "HTTP 5xx: {{ $labels.instance }}"
          description: "{{ $labels.instance }} is returning HTTP {{ $value }} status code."
⚠️ Važno: Ne postavljajte for trajanje prekratko. Privremene mrežne fluktuacije generisaće lažne uzbune. Za kritična upozorenja sačekajte najmanje 2 minuta, a za obična 5 minuta. Ipak, ova trajanja prilagodite svojim poslovnim zahtevima za brzo obaveštavanje tokom stvarnih prekida.
Konfiguracija Alertmanager-a
Alertmanager prima upozorenja od Prometheus-a, grupiše ih, potiskuje duplirana obaveštenja i usmerava ih na ispravan kanal. Mehanizmi usmeravanja, grupisanja i inhibicije sprečavaju zamor od upozorenja.
global:
  resolve_timeout: 5m
  slack_api_url: 'https://hooks.slack.com/services/T.../B.../xxx'

route:
  receiver: slack-default
  group_by: [alertname, instance]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    # Critical alerts go to PagerDuty
    - match:
        severity: critical
      receiver: pagerduty-critical
      repeat_interval: 1h
      continue: true

    # All alerts also go to Slack
    - match_re:
        severity: critical|warning
      receiver: slack-alerts

receivers:
  - name: slack-default
    slack_configs:
      - channel: '#monitoring'
        title: '{{ .GroupLabels.alertname }}'
        text: '{{ range .Alerts }}{{ .Annotations.description }}{{ end }}'

  - name: slack-alerts
    slack_configs:
      - channel: '#alerts-critical'
        color: '{{ if eq .Status "firing" }}danger{{ else }}good{{ end }}'
        title: '[{{ .Status | toUpper }}] {{ .GroupLabels.alertname }}'

  - name: pagerduty-critical
    pagerduty_configs:
      - service_key: 'your-pagerduty-integration-key'
        severity: critical

inhibit_rules:
  # Suppress HighResponseTime when EndpointDown is active
  - source_match:
      alertname: EndpointDown
    target_match:
      alertname: HighResponseTime
    equal: [instance]
Dashboard dostupnosti u Grafana-i
Vizuelizujte metrike Blackbox Exporter-a u Grafana-i kako biste status svih endpointa pratili na jednom panelu. Ključne metrike:
-
probe_success Da li je endpoint dostupan? 1 = uspeh, 0 = neuspeh. Pomoću Stat panela napravite zeleni/crveni indikator statusa.
-
probe_http_duration_seconds Vreme HTTP odgovora (faze DNS, povezivanje, TLS i prenos zasebno). Trendove analizirajte pomoću Time series panela.
-
Procenat dostupnosti (PromQL) Procenat dostupnosti u poslednjih 30 dana izračunajte pomoću
avg_over_time(probe_success[30d]) * 100.
Upravljanje dežurstvima i sprečavanje zamora od upozorenja
Efikasan sistem upozorenja treba da dostavi pravu informaciju pravoj osobi u pravo vreme. Preterano slanje upozorenja stvara „zamor od upozorenja“ i navodi timove da previde stvarne probleme.
Razdvajanje po ozbiljnosti
Kritično: odmah PagerDuty/telefon. Upozorenje: Slack obaveštenje. Informativno: samo dashboard.
Pravila inhibicije
Ako server potpuno otkaže, potisnite sva upozorenja servisa na tom serveru. Dovoljno je jedno obaveštenje o osnovnom uzroku.
Utišavanje i održavanje
Tokom planiranog održavanja kreirajte Alertmanager silences. Automatski se uklanjaju kada se održavanje završi.
Za metrike servera pogledajte naš vodič za Prometheus + Grafana. Za centralizovano upravljanje logovima pogledajte naš vodič za ELK Stack. Za upravljanje SSL sertifikatima pogledajte naš vodič za automatsku obnovu Let's Encrypt sertifikata. Zvanična Alertmanager dokumentacija i Blackbox Exporter na GitHub-u su korisni dodatni izvori.
Često postavljana pitanja
Mogu li da nadziram interne servise pomoću Blackbox Exporter-a?
Da, Blackbox Exporter nije ograničen na javne endpointe. Pomoću TCP sondi možete nadzirati interne API-je, portove baza podataka i veze sa redovima poruka. Mogu se proveravati i ClusterIP servisi u Kubernetes-u.
Koliko često treba proveravati dostupnost?
Za kritične servise preporučuju se intervali od 15-30 sekundi. Za manje kritične servise dovoljno je 1-5 minuta. Veoma česte provere (manje od 5 sekundi) mogu nepotrebno opteretiti ciljni servis i generisati lažne alarme.
Kako da kontrolišem ponavljanje upozorenja u Alertmanager-u?
Koristite parametar repeat_interval da biste odredili koliko često se isto upozorenje ponovo šalje. Razumne vrednosti su 1 sat za kritična i 4 sata za obična upozorenja. Nerešena upozorenja ponovo se šalju u ovom intervalu.
Mogu li da obavljam provere dostupnosti sa više lokacija?
Da, nadzor sa više lokacija možete postaviti instaliranjem Blackbox Exporter-a na različitim geografskim lokacijama. To pomaže da se otkriju regionalni mrežni problemi i smanjuje broj lažnih alarma. Preporučuje se provera sa najmanje 2-3 različite lokacije.
Zaključak
Neprekidno nadzirite svoje HTTP, TCP i DNS endpointe pomoću Prometheus Blackbox Exporter-a. Uz Alertmanager šaljite obaveštenja pravom timu preko pravog kanala tokom prekida. Sprečite zamor od upozorenja pravilima inhibicije i razdvajanjem po ozbiljnosti, a metrike dostupnosti vizuelizujte Grafana dashboardima.
Tražite infrastrukturu koja radi bez prekida?
Pouzdano pokrenite svoje servise na Hosted Cloud serverima sa garantovanom dostupnošću od 99,9%.
Pogledajte pakete cloud servera →Ahmet Yılmaz
Viši inženjer infrastrukture
Sa više od 10 godina iskustva u cloud infrastrukturi i DevOps-u, Ahmet se specijalizovao za Kubernetes, Terraform i arhitekture visoke dostupnosti.
Komentari uskoro